什麼是埃拉托斯特尼篩法? #
根據維基百科的解釋:
簡單的說,這是一個古老的質數篩選演算法,由古希臘數學家埃拉托斯特尼發明,用來找出某個範圍內所有的質數。
因為「埃拉托斯特尼篩法」念起來和輕小說標題一樣長,所以通常會簡稱為埃篩。
質數的定義 #
既然要找質數,先複習一下質數的定義,一樣來自維基百科的解釋:
為什麼需要埃拉托斯特尼篩法? #
主要是效能問題,直覺上要找數字 n 是否為質數可以這樣寫:
bool is_prime(int n){
	if(n < 2)
		return false;
	for(int i = 2 ; i * i <= n ; ++i){
		if(n % i == 0)
			return false;
	}
	return true;
}
*註:為了避免精度問題,i <= sqrt(n) 會寫成 i * i <= n
但這樣寫不夠好,時間複雜度是 \(O(n\sqrt{n})\),實際上有更好的方法,可以把時間複雜度降到 \(O(n\log( \log n))\) 甚至 \(O(n)\)
如何實作埃拉托斯特尼篩法? #
維基百科的這張 .gif 動圖很直觀的解釋了埃篩的做法:
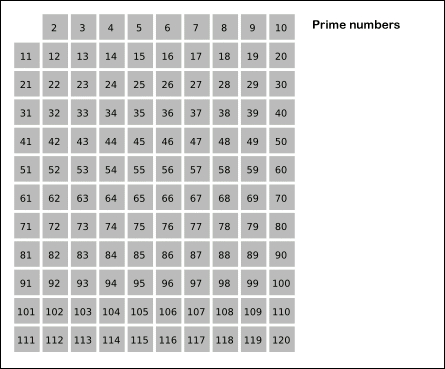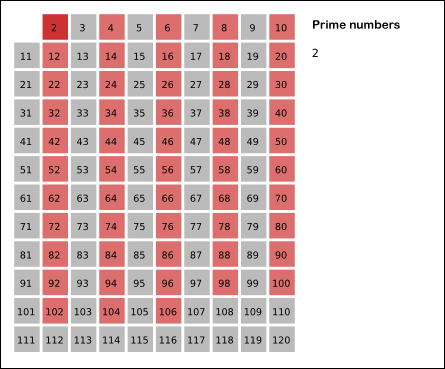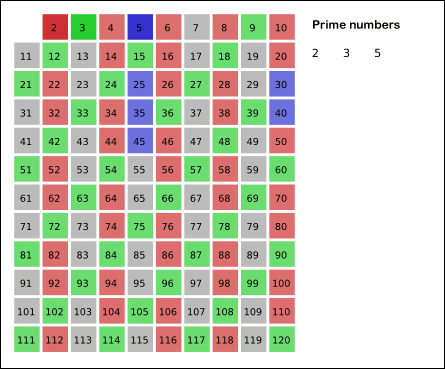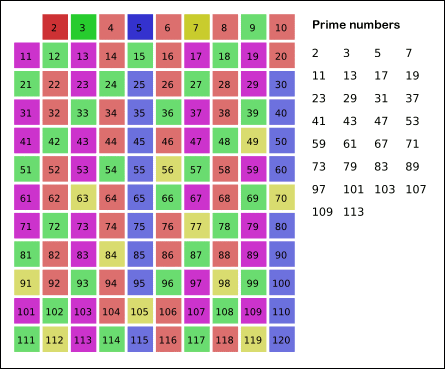
這張 .gif 圖是找 2 ~ 120 內的質數,不過,我們先縮小範圍用埃篩找 1 ~ 30 內的質數:
- 從 2 開始,標記 4, 6, 8, 10… 為合數
- 3 未被標記 → 是質數,標記 6, 9, 12, 15…
- 4 已被標記 → 跳過
- 5 未被標記 → 是質數,標記 10, 15, 20, 25…
- 只需篩到 \(\sqrt{30} \approx 5\) 即可停止
- 剩下未標記的:2, 3, 5, 7, 11, 13, 17, 19, 23, 29 即為質數
有個要注意的細節,為什麼只篩到 \(\sqrt{30} \approx 5\) ?
為什麼只篩到 \(\sqrt{30} \approx 5\) ? #
先確立目標: #
我們要證明的是:
對於範圍 [2, n] 內的每一個合數 c,它必定會被某個 \(\leq \sqrt{n}\) 的質數篩掉。
前置知識 #
首先要知道一些事情:
- 質數是只能被 1 和自身整除的整數(\(\geq 2\))。
- 合數是除了 1 和自身之外,還有其他因數的整數(\(\geq 2\))。
- 質因數分解唯一性(算術基本定理) 任何大於 1 的整數,都可以唯一地分解成質因數的乘積。
- 例:\(12 = 2^2 \times 3\) 分解方式唯一
核心引理 #
假設 \(c\) 是合數,且其所有質因數都 \(>\sqrt c\)。
因為 \(c\) 是合數,所以 \(c\) 至少包含兩個質因數,例如
$$ c=r\times k\times\cdots $$其中
$$ r>\sqrt c,\qquad k>\sqrt c $$因此
$$ c=rk\times\cdots>rk >\sqrt c\sqrt c=c $$得到矛盾 \(c>c\)。
所以不可能所有質因數都 \(>\sqrt c\),因此至少有一個質因數
$$ p\leq\sqrt c $$而最小質因數當然也滿足
\(p \le c\)
主定理 #
最後,終於來證明一開始想要證明的東東:
篩法只需對 [2, √n] 內的質數執行篩除,即可找出 [2, n] 內所有質數
證明:
取 \([2, n]\) 內任意一個合數 \(c\),我們要證明它「一定會被篩掉」。
-
Step 1: \(c\) 有最小質因數 \(p\)。
-
Step 2: 由引理,\(p \leq \sqrt{c}\)。
-
Step 3: 因為 \(c \leq n\),所以:
$$p \leq \sqrt{c} \leq \sqrt{n}$$ -
Step 4: 篩法會處理所有 \(\leq \sqrt{n}\) 的質數,而 \(p \leq \sqrt{n}\),所以 \(p\) 會被處理到。
-
Step 5: 篩法處理 \(p\) 時,會標記 \(p\) 的所有倍數。而 \(c\) 是 \(p\) 的倍數(因為 \(p\) 是 \(c\) 的因數),所以 \(c\) 必定被標記為合數。
由於 \(c\) 是 \([2, n]\) 內任意合數,這對所有合數都成立。
所以所有合數都被篩掉,剩下未標記的就全是質數!
程式模板 #
以下程式由萬能的 Claude 產生
#include <iostream>
#include <vector>
using namespace std;

const int MAXN = 1e7 + 5;
bool is_composite[MAXN]; // is_composite[i] = true 表示 i 是合數,預設 false(質數)
vector<int> primes; // 儲存所有找到的質數

void sieve(int n) {
    // 0 和 1 不是質數
    is_composite[0] = is_composite[1] = true;

    for (int i = 2; i * i <= n; ++i) {
        // 若 i 未被標記,i 是質數
        if (!is_composite[i]) {
            // 從 i*i 開始標記,因為比 i*i 小的 i 的倍數
            // 早已被更小的質數標記過,不需重複處理
            for (int j = i * i; j <= n; j += i) {
                is_composite[j] = true;
            }
        }
    }

    // 收集所有質數
    for (int i = 2; i <= n; ++i) {
        if (!is_composite[i]) {
            primes.push_back(i);
        }
    }
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n;
    cin >> n;

    sieve(n);

    // 範例:輸出質數個數與前 10 個質數
    cout << "質數個數:" << primes.size() << "\n";
    cout << "前 10 個質數:";
    for (int i = 0; i < min((int)primes.size(), 10); ++i) {
        cout << primes[i] << " ";
    }
    cout << "\n";

    // 範例:O(1) 查詢某數是否為質數
    int q;
    cin >> q;
    cout << q << (is_composite[q] ? " 不是質數" : " 是質數") << "\n";

    return 0;
}
雖然前面有提到,但還是提醒一下:
為了避免精度問題,
i <= sqrt(n)會寫成i * i <= n
另外,實際埃篩的程式不包含 primes.push_back() 的部分,這邊只是順便放進來,Claude 甚至連使用範例都準備好了
線性篩(歐拉篩) #
線性篩(歐拉篩)是埃拉托斯特尼篩法的一種優化版本,其時間複雜度為 \(O(n)\),接下來會來解釋線篩的運作方式。
在開始介紹線篩,先來回顧一下埃篩的一個問題,即合數會被重複標記,舉一個例子:
- 12 會被標記兩次:
- 處理質數 2 時:2 × 6 = 12 ✓
- 處理質數 3 時:3 × 4 = 12 ✓ ← 重複了!
而線篩就是優化了這一部分,使其時間複雜度降到 \(O(n)\)
線篩的核心思想 #
讓每個合數只被它的「最小質因數」篩掉(<- 這是重點!),且只篩一次。
要做到這件事,需要在篩的過程中動態維護已找到的質數清單,並對每個數 i,用「i × 已知質數」來標記合數,一旦觸發停止條件就立刻 break。
以 n = 12 為例 #
primes = []

i = 2:
  2 未被標記 → 加入 primes = [2]
  j = 2:標記 2×2 = 4,  2 % 2 == 0 → break

i = 3:
  3 未被標記 → 加入 primes = [2, 3]
  j = 2:標記 3×2 = 6,  3 % 2 ≠ 0 → 繼續
  j = 3:標記 3×3 = 9,  3 % 3 == 0 → break

i = 4:
  4 已被標記 → 不加入 primes
  j = 2:標記 4×2 = 8,  4 % 2 == 0 → break   ← 注意:不是質數也要跑這步!

i = 5:
  5 未被標記 → 加入 primes = [2, 3, 5]
  j = 2:標記 5×2 = 10,  5 % 2 ≠ 0 → 繼續
  j = 3:標記 5×3 = 15,  5 % 3 ≠ 0 → 繼續
  j = 5:標記 5×5 = 25,  5 % 5 == 0 → break

i = 6:
  6 已被標記 → 不加入 primes
  j = 2:標記 6×2 = 12,  6 % 2 == 0 → break
在以上例子中,j 是從 primes 抓出來的「已知質數」,每次都用 i x j 來標記合數,接著在判斷 i / j 能否整除,如果可以,那就 break;若不行,再從primes 抓下一個「已知質數」來當 j
為什麼 i % prime == 0 就要 break?
#
1. 目的:防止重複標記 #
假設現在 i = 6,處理到 prime = 3:
(實際在演算法中,i = 6 會在 prime = 2 時被 break 掉,這裡假設的是沒有被 break 掉)
- 想標記 6 × 3 = 18
- 但 18 = 2 × 9 = 2 × 3²
- 18 的最小質因數是 2,不是 3
- 18 應該由 i=9 時,用 9×2 來標記
- 現在標記是重複的,所以 break
2. 推導 #
當流程進行到 i % prime == 0 時,因為質數是由小到大窮舉,代表 prime 是 i 的 最小質因數,設 \(i = prime \times k\) 。(因為 \(k\) 是和 \(i\) 一起從 \(prime\) 拆來的,所以 \(prime\) 會小於或等於 \(k\) 裡面的所有質因數。)
那麼,下一個想標記的合數 \(r\) 會是 \(r = i \times next_{prime}\),把它們合在一起就是:
\(r = i \times next_{prime} = (prime \times k) \times next_{prime}\)
因為質數遞增, \(prime\) 一定會比 \(next_{prime}\) 小,所以 \(prime\) 才是 \(r\) 真正的最小質因數,因此 \(r\) 應該在未來當外層數字變為 \(i' = k \times next_{prime}\) 時,搭配質數 \(prime\) 來篩掉,這也是為什麼現在必須 break。
為什麼這樣能保證每個合數恰好被篩一次? #
每個合數 c 都有唯一的最小質因數 p,可以寫成:
c = p × (c / p)
  = p × i        其中 i = c/p,且 p 是 c 的最小質因數
歐拉篩保證:當迴圈跑到 i 時,p 一定在 primes 裡,且不會 break 提前結束,所以 c 只會被標記一次。
程式碼 #
const int MAXN = 1e7 + 5;
bool is_composite[MAXN]; // is_composite[i] = true 表示 i 是合數,預設 false(質數)
vector<int> primes; // 儲存所有找到的質數

void linear_sieve(int n) {
    for (int i = 2; i <= n; ++i) {
        if (!is_composite[i])
            primes.push_back(i);          // i 是質數,加入清單

        for (int p : primes) {
            if ((long long)i * p > n) break;     // 超出範圍
            is_composite[i * p] = true;           // 用最小質因數 p 標記合數

            if (i % p == 0) break;        // ← 核心:確保每個合數只被篩一次
        }
    }
}
莫比烏斯函數篩 #
厄 … 這也是一個從埃篩延伸出來的東西,但應該用不到,所以只是記錄一下有這個東西,絕對不是我看它有點複雜,所以懶得研究
(下圖為我看到莫比烏斯函數時的表情)
( 圖片來源:《蒼之彼方的四重奏》)